


Ob Sie alles auf einem Server betreiben oder auf mehrere verteilen, hat drei Auswirkungen: Ihre monatlichen Kosten, Ihre Verfügbarkeit und den Zeitaufwand Ihres Teams für den Betrieb.
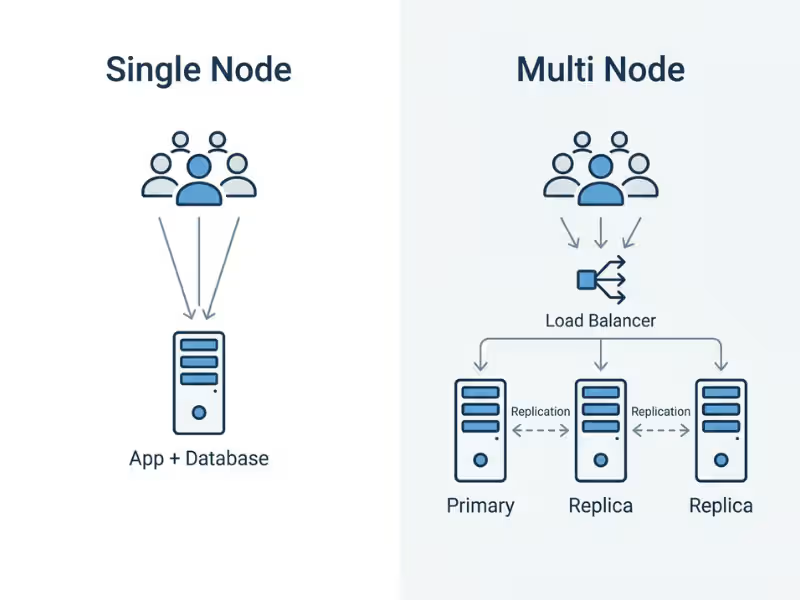
Bei einer Einzelknotenkonfiguration wird die gesamte Arbeitslast auf einem einzigen Rechner ausgeführt. Eine Mehrknotenkonfiguration verwendet zwei oder mehr Rechner, die als ein System zusammenarbeiten.
Viele Teams wählen ein bestimmtes Setup aus Gewohnheit, nicht weil es die Arbeitslast erfordert. In diesem Leitfaden erkläre ich die tatsächlichen Vor- und Nachteile und zeige, wo welches Setup am besten passt. Außerdem stelle ich Ihnen eine Checkliste zur Verfügung, die Ihnen bei der Entscheidung hilft.
Einzelknoten und Mehrfachknoten in einfachen Worten
Beide Konfigurationen können dieselbe Anwendung ausführen. Der Unterschied liegt darin, wo die eigentliche Arbeit stattfindet und was bei einem Fehler beeinträchtigt wird. Schauen wir uns beides anhand praktischer Beispiele an.
So sieht ein Einzelknoten-Setup aus
Ein einzelner Knoten ist eine Maschine, die alle Aufgaben erledigt. Ihre CPU, ihr Arbeitsspeicher, ihre Festplatte und ihre Netzwerkkarte bearbeiten jede Anfrage, jede Abfrage und jeden Schreibvorgang.
Da keine Daten zwischen den Servern übertragen werden, bleiben die Anfragen schnell. Auch die Fehlersuche bleibt einfach. Im Fehlerfall muss man nur einen Satz Protokolle auf einem einzigen Server überprüfen.
Der Kompromiss ist einfach: Diese Maschine stellt einen einzigen potenziellen Fehlerpunkt dar. Fällt sie aus, ist auch Ihr Service nicht mehr verfügbar.
Diese Konfiguration sieht man überall. Ein PostgreSQL-Server hinter einer internen Firmenanwendung ist ein typisches Beispiel. Genauso wie eine Heimanwendung, die auf einem kleinen Server in einem Abstellraum läuft.
So sieht ein Multi-Node-Setup aus
Eine Multi-Node-Konfiguration verbindet mehrere Rechner über ein Netzwerk. Sie tauschen Daten und/oder Aufgaben aus. Drei Konzepte leisten dabei den größten Beitrag:
- Replikation Speichert Kopien derselben Daten auf mehreren Knoten.
- Lastverteilung Verteilt eingehende Anfragen auf die verschiedenen Knoten.
- Schärfen Die Daten werden so aufgeteilt, dass jeder Knoten nur einen Teil davon enthält.
Knoten übernehmen üblicherweise Rollen. Ein Leader nimmt Schreibvorgänge entgegen, Worker verarbeiten Aufträge, und Replikate halten Kopien zum Lesen und zur Datensicherung bereit.
Viele Teams übersehen einen wichtigen Punkt: „Multi-Node“ kann zwei unterschiedliche Ziele verfolgen. Replikate schützen hauptsächlich die Verfügbarkeit und erhöhen die Lesekapazität. Sharding und Worker-Pools erhöhen die Gesamtkapazität. Ein Replikatset mit drei Knoten übersteht zwar einen Ausfall, verdreifacht aber nicht die Schreibgeschwindigkeit. Jeder Schreibvorgang läuft weiterhin über einen primären Knoten.
Drei Knoten bedeuten also selten die dreifache Geschwindigkeit. Koordination, Netzwerk-Hops und Replikation verlangsamen die Abläufe.
Dieses Muster findet man in Kubernetes-Clustern, Elasticsearch-Clustern mit drei Knoten und MongoDB-Replikatsätzen.
Einzelknoten vs. Mehrknoten: Ein Vergleich
Keine der beiden Varianten ist generell besser; die richtige Wahl hängt davon ab, welche dieser Faktoren für Sie am wichtigsten sind. Ich habe sie paarweise zusammengefasst, da sie sich in realen Einsätzen gegenseitig beeinflussen. Eine kostengünstige Lösung ist selten die einfachste, und eine schnelle ist nicht immer die sicherste.
Leistung und Skalierbarkeit
Ein einzelner Knoten beantwortet Anfragen oft schneller. Die Daten bleiben im lokalen Speicher, und es werden keine Netzwerkdaten übertragen. In einem Cluster kann eine Anfrage hingegen bis zu drei Maschinen durchlaufen, bevor sie zurückkommt.
Mehrere Knoten bieten einen höheren Gesamtdurchsatz. Zehn Worker können zehn Aufträge gleichzeitig bearbeiten, und diese parallele Kapazität ist bei großen Datenmengen entscheidend. Allerdings ist bei der synchronen Replikation Vorsicht geboten. Jeder Schreibvorgang wartet auf die Bestätigung mindestens eines anderen Knotens, wodurch er sich etwas verlangsamt.
Vertikale Skalierung geht weiter, als die meisten Teams erwarten. Ein moderner Server mit zwei Prozessorsockeln kann Hunderte von CPU-Kernen und mehrere Terabyte Arbeitsspeicher beherbergen. Viele Workloads, die eigentlich einen Cluster erfordern, lassen sich auf einem einzigen, gut ausgestatteten Server ausführen.
Horizontale Skalierung funktioniert nur, wenn Ihre Anwendung dies unterstützt. Eine Anwendung, die Sitzungen lokal speichert oder in eine einzige Datenbank schreibt, wird durch das Hinzufügen von Servern nicht beschleunigt. Sie müssen die horizontale Skalierung von Anfang an berücksichtigen, bevor Sie sie nutzen können.
Zuverlässigkeit und Wartung
Auf einem einzelnen Knoten bedeutet ein einziger Fehler einen kompletten Ausfall. Eine defekte Festplatte, ein fehlerhaftes Netzteil oder ein Kernel-Panic legen den gesamten Dienst lahm.
Eine Multi-Node-Architektur kann einen Ausfall überstehen, aber nur, wenn ein Failover konfiguriert und getestet wird. Ich habe schon Cluster ausfallen sehen, weil der Backup-Knoten nie die Funktion übernommen hatte. Die meisten Cluster verwenden drei Knoten, damit sich die Mehrheit auch nach dem Ausfall eines Knotens noch auf den aktuellen Zustand einigen kann.
Die Wartung weist dieselbe Lücke auf. Auf einem einzelnen Knoten erfordert jeder Patch, jedes Kernel-Update oder jede Datenbankaktualisierung ein Ausfallzeitfenster, oft spät in der Nacht. Eine Multi-Node-Umgebung ermöglicht hingegen rollierende Aktualisierungen. Man aktualisiert jeweils einen Knoten, während die anderen weiterhin den Datenverkehr bedienen, sodass die Benutzer nichts davon bemerken.
Kosten und betriebliche Komplexität
Ein Cluster mit drei Knoten kostet weit mehr als das Dreifache der Hardware. Hier ein Beispiel mit typischen Zahlen:
- Ein Server: etwa 400 Dollar pro Monat für Hardware, plus etwa 2 Stunden Verwaltungszeit.
- Drei-Knoten-Cluster: Etwa 1,200 US-Dollar für Hardware, 100–200 US-Dollar für Lastverteilung und Netzwerk, 50–100 US-Dollar für Überwachung und Softwarelizenzen pro Knoten. Hinzu kommen 8–12 Stunden Ingenieursarbeit pro Monat.
Bei einem Stundensatz von 100 Dollar für die Entwicklung kostet ein einzelner Server etwa 600 Dollar im Monat. Der Cluster schlägt mit rund 2,300 Dollar oder mehr zu Buche, also fast viermal so viel.
Die Komplexität steigt ebenso schnell. Verteilte Ausfälle sind schwieriger zu diagnostizieren. Cluster bringen Probleme mit sich, die ein einzelner Server nie hat:
- Netzwerkpartitionen: Die Knoten können einander nicht erreichen.
- Split-Brain: Zwei Knotenpunkte glauben beide, sie seien der Anführer.
- Teilweise Ausfälle: Manche Anfragen schlagen fehl, andere sind erfolgreich.
Ihr Team benötigt die Fähigkeiten, diese Probleme zu finden und zu beheben, oft unter Druck.
Datenkonsistenz
Ein einzelner Knoten hält Transaktionen einfach. Ein Schreibvorgang ist entweder erfolgreich oder schlägt fehl, und jeder Leser sieht sofort dieselben Daten.
Mehrere Knoten ändern das. Replikate können dem primären Knoten um Millisekunden oder Sekunden hinterherhinken. Manche Systeme verwenden letztendliche Konsistenz, sodass ein Benutzer sein Profil aktualisieren und kurzzeitig noch die alte Version sehen kann.
Das CAP-Theorem fasst diesen Zielkonflikt zusammen. Wenn sich das Netzwerk aufteilt, muss ein verteiltes System zwischen Verfügbarkeit und Konsistenz wählen. Sie entscheiden, auf welche dieser beiden Optionen Ihre Benutzer verzichten können.
Direktvergleich
|
Faktor |
Einzelner Knoten |
Mehrere Knoten |
Was es für Sie bedeutet |
|---|---|---|---|
|
Leistung |
Schnellere Bearbeitung pro Anfrage |
Höherer Gesamtdurchsatz |
Auswahl nach Latenz- vs. Volumenbedarf |
|
Zuverlässigkeit |
Ein Ausfall bedeutet Ausfallzeit |
Übersteht Ausfälle, wenn das Failover funktioniert |
Testen Sie den Failover, bevor Sie ihm vertrauen. |
|
Skalierbarkeit |
Vertikal, begrenzt durch ein Kästchen |
Horizontal, benötigt App-Unterstützung |
Einen Server zuerst auslasten |
|
Kosten |
Geringere Hardware- und Arbeitskosten |
3–4-mal höher, einschließlich der Operationszeit |
Zählen Sie die Ingenieurstunden, nicht nur die Hardware. |
|
Komplexität |
Eine Box, einfache Fehlersuche |
Partitionierung, Split-Brain-Problem, Teilausfälle |
Passe die Spielsituation an die Fähigkeiten des Teams an. |
|
Datenkonsistenz |
Immer konsequent |
Replikationsverzögerung möglich |
Prüfen Sie, ob Benutzer veraltete Lesevorgänge tolerieren. |
|
Wartung |
Benötigt Ausfallzeiten |
Laufende Upgrades, keine Ausfallzeiten |
Patch-Häufigkeit und Verfügbarkeitsziele gegeneinander abwägen |
Wann ein einzelner Knoten die richtige Lösung ist
Ein einzelner Server ist weder eine Abkürzung noch ein Kompromiss. Für viele Arbeitslasten ist er die intelligenteste Lösung, und ich empfehle ihn viel häufiger, als man denkt.
Es passt am besten, wenn:
- Der Verkehr bleibt gering oder vorhersehbar., ohne plötzliche Spitzen
- Sie entwickeln ein MVP oder einen Prototypen und teste die Idee noch.
- Sie führen interne Tools aus die ein paar Dutzend Leute benutzen
- Ihre Arbeitslast bleibt auch in Spitzenzeiten deutlich unter den Kapazitätsgrenzen einer einzelnen Maschine.beispielsweise unter 50 % CPU- und Speicherauslastung
- Sie benötigen Entwicklungs- und Testumgebungen. die Spiegelproduktion billig
Hier ein häufig beobachteter Fall: Ein SaaS-Startup bedient seine ersten 1,000 Nutzer mit einer einzigen verwalteten Datenbank. Der Anbieter führt automatisierte Backups und eine Wiederherstellung zu einem bestimmten Zeitpunkt durch, sodass das Team auf jeden beliebigen Zeitpunkt der letzten Woche zurückgreifen kann. Die Kunden können mit wenigen Minuten Ausfallzeit pro Quartal leben. Ein Cluster würde zusätzliche Kosten und einen erhöhten Bereitschaftsdienstaufwand verursachen, und die Nutzer würden den Unterschied nicht bemerken.
Dennoch sollte „einzelner Knoten“ niemals „ungeschützt“ bedeuten. Vier Gewohnheiten machen einen Server sicher genug für den Produktiveinsatz:
- Stellen Sie Ihre Backups wieder her. Nehmen Sie sie nicht einfach mit. Einmal im Monat sollten Sie die Daten auf einem Ersatzrechner wiederherstellen und öffnen. Solange Sie keine Datensicherung wiederhergestellt haben, können Sie sich nicht darauf verlassen.
- Kenne zwei Zahlen. Wie lange können Sie während der Wiederherstellung offline bleiben? Wie viele Minuten an aktuellen Daten können Sie verkraften zu verlieren? Lauten die Antworten „eine Stunde“ und „fünf Minuten“, passen Sie Ihren Backup-Zeitplan entsprechend an.
- Überwachung und Benachrichtigungen einrichten. Behalten Sie CPU-Auslastung, Arbeitsspeicher, Festplattenspeicher und den Erfolg Ihrer Datensicherung im Blick. Lassen Sie sich benachrichtigen, sobald die Festplatte 80 % erreicht, damit Sie nachts um 2 Uhr nicht von einem vollen Speicherplatz überrascht werden.
- Beschreiben Sie den Wiederaufbauprozess. Beschreiben Sie jeden einzelnen Schritt, von der Bereitstellung eines neuen Servers bis zum DNS-Wechsel. Bitten Sie anschließend eine andere Person als den Autor, diese Schritte nachzuvollziehen.
Betrachten wir nun die Kosten. Laut den vorherigen Angaben kostet ein Server inklusive Administrationszeit etwa 600 US-Dollar pro Monat. Ein Cluster mit drei Knoten kostet hingegen rund 2,300 US-Dollar. Das entspricht einer Differenz von etwa 1,700 US-Dollar monatlich bzw. mehr als 20,000 US-Dollar jährlich.
Dieses Budget deckt externe Backups, einen größeren Server mit Erweiterungsmöglichkeiten und ein verbessertes Monitoring ab. Es bleibt noch genügend Geld für die Produktentwicklung übrig. Für ein junges Team sind diese Funktionen in der Regel wichtiger für die Kunden als ein zweiter und dritter Serverknoten.
Wenn Sie mehrere Knoten benötigen
Irgendwann ist ein Server einfach nicht mehr die beste Wahl. Die Anzeichen dafür sind meist eindeutig, wenn man weiß, worauf man achten muss. Diese vier tauchen immer wieder auf:
- Sie garantieren im Vertrag Verfügbarkeit. Eine Verfügbarkeitsgarantie von 99.9 % erlaubt etwa 43 Minuten Ausfallzeit pro Monat. Bei 99.99 % sind es nur noch etwa 4.3 Minuten. Ein einziger Neustart oder Festplattentausch kann dieses gesamte Budget aufbrauchen.
- Der Verkehr steigt rapide und schnell an. Eine Produkteinführung, ein viraler Beitrag oder ein Blitzverkauf können Ihnen innerhalb weniger Minuten das Zehnfache Ihres normalen Umsatzes einbringen.
- Ihre Datenmenge übersteigt die Kapazität eines einzelnen Rechners. Wenn der Speicherbedarf die Kapazität eines einzelnen Geräts übersteigt, muss die Last verteilt werden.
- Für die Einhaltung von Vorschriften oder die Wiederherstellung nach Katastrophen ist es erforderlich. Manche Kunden und Branchen benötigen Live-Kopien der Daten an einem zweiten Standort.
Nehmen wir einen Online-Shop, der sich auf den Weihnachtsverkauf vorbereitet. Letztes Jahr verdreifachte sich der Traffic in der ersten Stunde, und der Bezahlvorgang verlangsamte sich extrem. Dieses Jahr arbeitet das Team in drei Schritten:
- Zuerst die Ebene der zustandslosen Anwendungen ausbauen. Webserver speichern keine Daten, daher ist das Hinzufügen weiterer Server hinter einem Load Balancer schnell und risikoarm.
- Füge Datenbank-Lesereplikate hinzu. Produktseiten und Suchanfragen werden von Replikaten gelesen, Bestellungen werden jedoch weiterhin an das Hauptkonto gesendet.
- Lasttests sollten Wochen im Voraus durchgeführt werden, nicht Tage. Frühe Tests lassen Zeit, um den aufgedeckten Engpass zu beheben. Und fast immer wird ein solcher Engpass aufgedeckt.
Sie brauchen keine Krise, um mit der Planung zu beginnen. Achten Sie auf die Spitzenwerte, nicht auf die Durchschnittswerte. Wenn die CPU-, RAM- oder Festplattenauslastung während der Spitzenzeiten bei etwa 70 % liegt, sollten Sie mit der Planung beginnen. Dies ist ein Hinweis auf bevorstehende Ereignisse, kein Notfall. Sie haben noch Kapazitäten frei, aber nicht mehr unbegrenzt.
Behalten Sie auch im Blick, wie schnell Ihre Festplatte voll wird. Bei einer monatlichen Nutzungsrate von 5 % ist eine Festplatte, die zu 60 % ausgelastet ist, nach etwa acht Monaten voll. Hinzu kommt die Vorlaufzeit. Die Umstellung auf Multi-Node-Architektur kann Wochen an Planung, Tests und Datenmigration in Anspruch nehmen. Beginnen Sie daher rechtzeitig, bevor der Speicherplatz knapp wird.
Der Umstieg auf Multi-Node-Architekturen bedeutet nicht, alles gleichzeitig zu clustern. Die meisten Teams, mit denen ich zusammenarbeite, bewegen sich irgendwo dazwischen.
Der Mittelweg, den die meisten Teams tatsächlich nutzen
Die Entscheidung ist selten eine Alles-oder-Nichts-Entscheidung. Ein sehr häufiges Setup sieht folgendermaßen aus: mehrere Anwendungsserver hinter einem Load Balancer sowie eine primäre Datenbank mit einer Standby-Replika, die bereit ist, bei Bedarf zu übernehmen.
Diese Konfiguration platziert den Schutz dort, wo Ausfälle am meisten schaden. Anwendungsserver lassen sich kostengünstig duplizieren und leicht austauschen. Die Datenbank erhält ein Sicherheitsnetz ohne die Komplexität von Sharding.
Fügen Sie anschließend schrittweise Redundanz hinzu. Duplizieren Sie den Cache, sobald er kritisch wird. Fügen Sie Lesereplikate hinzu, wenn sich die Anfragen häufen. Jeder Schritt sollte ein konkretes, messbares Problem lösen.
Häufige Missverständnisse über Einzelknoten und Mehrknoten
Die meisten Fehlentscheidungen im Bereich der Architektur beginnen mit einer zunächst plausibel klingenden Annahme. Ich höre in fast jeder Planungsbesprechung dieselben fünf Annahmen. Jede einzelne führt dazu, dass Teams eine Lösung wählen, die entweder teurer ist oder weniger Schutz bietet als erwartet.
„Mehrere Knoten sind immer besser“
Mehr Maschinen klingen sicherer und professioneller. Viele Teams betrachten einen Cluster daher als die optimale Lösung. Das ist er aber nicht automatisch.
Ein Cluster erfordert zusätzliche Hardware, Netzwerkfunktionen, Überwachung und Bereitschaftsdienst. Basierend auf den vorherigen Zahlen summiert sich das auf monatliche Mehrkosten von etwa 1,700 US-Dollar. Wenn Ihr Datenverkehr auf einem Server abgewickelt werden kann und Ihre Benutzer kurze Ausfälle akzeptieren, zahlen Sie diesen Aufpreis für einen Schutz, den Sie nie in Anspruch nehmen.
„Besser“ bedeutet, dass es zu Ihrer Arbeitslast passt, nicht, dass mehr Geräte im Regal stehen.
„Ein einzelner Knoten kann die Produktion nicht ausführen“
Viele Kleinunternehmen betreiben jahrelang nur einen Server ohne größere Zwischenfälle. Buchhaltungssysteme, Buchungs-Apps und interne Portale laufen oft auf einem einzigen Rechner und funktionieren einwandfrei.
Ein zweiter Knoten allein gewährleistet keine Sicherheit. Getestete Backups, Warnmeldungen vor dem Volllaufen der Festplatte und ein schriftlicher Wiederherstellungsplan leisten hier ganze Arbeit. Ich habe schon erlebt, wie ein gut gewarteter Einzelserver Cluster überdauert hat, die im Team von niemandem vollständig verstanden wurden.
Wie gut Sie sich erholen, ist wichtiger als die Anzahl der von Ihnen betriebenen Maschinen.
„Das Hinzufügen von Knoten behebt eine langsame App“
Diese Annahme kann schnell teuer werden. Eine langsame Anwendung hat in der Regel eine konkrete Ursache: eine Abfrage, die eine ganze Tabelle durchsucht, ein fehlender Index oder eine Seite, die die Datenbank fünfzig Mal aufruft.
Fügt man drei Knoten hinzu, wird dieselbe fehlerhafte Abfrage nun auf drei Maschinen ausgeführt. Die Kosten steigen, und die Benutzer müssen weiterhin warten.
Erstellen Sie zunächst ein Profil. Identifizieren Sie Ihre langsamsten Abfragen und beheben Sie diese. Eine einzeilige Indexänderung ist oft effektiver als ein neuer Cluster und kostet nichts.
„Mehr Knoten bedeuten keine Ausfallzeiten“
Zusätzliche Knoten schützen vor einer bestimmten Art von Ausfall: dem Ausfall einer einzelnen Maschine. Gegen die übrigen Maschinen bieten sie wenig Nutzen.
Ein Failover, der nicht getestet wurde, kann genau dann ausfallen, wenn man ihn braucht. Drei Knoten in einem Rack teilen sich möglicherweise eine Steckdosenleiste oder einen Switch. Eine fehlerhafte Bereitstellung verteilt dieselbe fehlerhafte Konfiguration gleichzeitig auf alle Knoten.
Verteilen Sie die Knoten über Racks, Stromversorgungen oder Zonen. Führen Sie dann an einem ruhigen Nachmittag eine Ausfallübung durch, damit ein tatsächlicher Stromausfall nicht Ihr erster Test ist.
„Managed Services treffen die Entscheidung für Sie.“
Verwaltete Datenbanken und Kubernetes-Dienste übernehmen Patches, Backups und Failover. Das ist ein echter Mehrwert. Doch sie beseitigen den Zielkonflikt nicht, sondern verlagern ihn.
Sie zahlen für jeden Knoten einen Aufpreis, oft das Zwei- bis Dreifache der reinen Rechenkosten. Außerdem sind Sie mit Ihrer Konfiguration an die APIs, Limits und Preisgestaltung eines einzigen Anbieters gebunden.
Sie müssen sich weiterhin zwischen einer Einzelinstanz- und einer Hochverfügbarkeitslösung entscheiden. Sie müssen weiterhin abwägen, ob Ihre Arbeitslast die zusätzlichen Kosten rechtfertigt.
Jeder dieser Mythen überspringt denselben Schritt: die Messung dessen, was Ihre Arbeitsbelastung tatsächlich erfordert.
Wie Sie die richtige Entscheidung treffen: Eine praktische Checkliste
Sie kennen nun die Vor- und Nachteile. Im nächsten Schritt wenden Sie diese auf Ihre eigene Arbeitsbelastung an. Beantworten Sie die folgenden Fragen anhand konkreter Zahlen aus Ihrem Monitoring und Ihrer Abrechnung, nicht anhand Ihres Bauchgefühls.
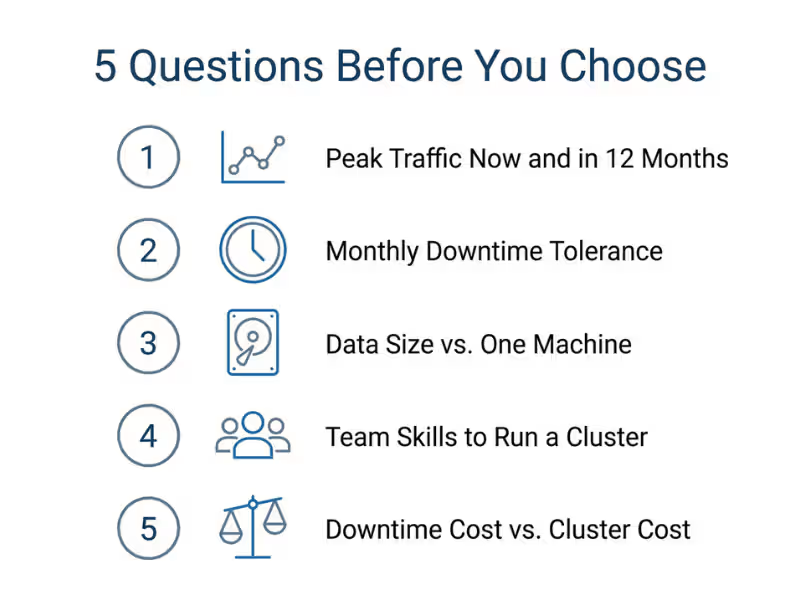
Fünf Fragen, die Sie zuerst beantworten sollten
Bevor wir uns mit einem Diagramm befassen, stelle ich jedem Team diese fünf Fragen. Notieren Sie die Antworten, denn sie klären die meisten Diskussionen schnell.
- Wie hoch ist Ihr aktuelles Datenaufkommen und wie wird es in 12 Monaten aussehen? Verwenden Sie die Spitzenanfragen pro Sekunde, nicht die Tagesdurchschnittswerte. Die 12-Monats-Zahl sollte dann auf Ihrer Wachstumsrate oder Ihrem Umsatzplan basieren, nicht auf Hoffnungen.
- Wie viel Ausfallzeit können Ihre Nutzer pro Monat tolerieren? Zehn Minuten mögen für ein internes Tool ausreichen. Für eine Checkout-Seite könnten sie jedoch Umsatzeinbußen und verärgerte E-Mails bedeuten.
- Passen Ihre Daten heute noch auf einen Rechner? Werden sie in einem Jahr noch passen? Vergleichen Sie Ihre aktuelle Speicher- und Arbeitsspeichernutzung mit dem größten Server, den Sie realistischerweise kaufen oder mieten können.
- Kann Ihr Team einen Cluster betreiben? Wenn noch nie jemand einen Failover oder Split-Brain-Szenario durchgeführt hat, benötigen Sie Schulungszeit oder ein Budget für einen Managed Service.
- Was kostet Sie eine Stunde Ausfallzeit im Vergleich zu einem Jahr Clusterbetrieb? Diese Frage ist meist ausschlaggebend. Angenommen, ein Ausfall kostet Sie 500 US-Dollar pro Stunde und Sie rechnen mit etwa vier Stunden Ausfallzeit pro Jahr. Das sind 2,000 US-Dollar, gegenüber zusätzlichen Clusterkosten von rund 20,000 US-Dollar. Ein einzelner Server ist hier eindeutig die bessere Wahl. Kostet diese Stunde 10,000 US-Dollar, amortisiert sich der Cluster bereits nach zwei Ausfällen.
Entscheidungsleitfaden
Sobald Sie Ihre Antworten haben, wird die Entscheidung meist klar.
Wählen Sie einen einzelnen Knoten, wenn Ihre Benutzer kurze Ausfälle tolerieren können, Ihre Arbeitslast ausreichend Spielraum bietet und Ihr Wachstum vorhersehbar bleibt.
Wählen Sie Multi-Node, wenn ein Vertrag die Verfügbarkeit garantiert, Ihre Daten schneller wachsen, als eine einzelne Maschine bewältigen kann, oder Ihr Datenverkehr ohne Vorwarnung sprunghaft ansteigt.
Wählen Sie einen Mittelweg, wenn nur eine Ebene kritisch ist. Oft ist diese Ebene die Datenbank, und der Rest kann einfach gehalten werden.
|
Wenn Ihre Situation folgende ist… |
Beginnen mit… |
|---|---|
|
MVP, internes Tool oder konstant niedriger Datenverkehr |
Ein Server mit getesteten Backups |
|
Ausfallzeiten verursachen geringe Kosten, aber das Wachstum steht bevor. |
Ein größerer Server, der für eine spätere Skalierung ausgelegt ist. |
|
Hohe Auslastung der Anwendungsebene, Daten passen in eine Datenbank |
Mehrere Anwendungsserver sowie eine primäre und eine Standby-Datenbank |
|
Vertraglich vereinbarte Service-Level-Vereinbarung (SLA) von 99.9 % oder höher |
Mehrere Knoten über separate Racks oder Zonen hinweg |
|
Datenmengen wachsen innerhalb eines Jahres über eine einzelne Maschine hinaus. |
Replikate jetzt, Sharding-Plan bereit |
Migrationspfad: Beginnen Sie mit einer Einzelperson, planen Sie für mehrere.
Mit einem einzigen Server zu beginnen, schränkt Sie nicht ein. Treffen Sie frühzeitig einige Designentscheidungen, und der spätere Wechsel wird zur Routine anstatt einer kompletten Neuentwicklung.
Entwickeln Sie diese Gewohnheiten vom ersten Tag an:
- Die App sollte zustandslos bleiben. Jeder Anwendungsserver sollte in der Lage sein, jede Anfrage zu bearbeiten, ohne dass Dateien oder Benutzerdaten lokal gespeichert werden.
- Sitzungen werden außerhalb des Anwendungsservers gespeichert. Speichern Sie sie in Redis, einer Datenbank oder signierten Cookies, damit ein neuer Server jeden Benutzer erkennen kann.
- Die Verbindung erfolgt über einen DNS-Namen oder Endpunkt, nicht über eine fest codierte IP-Adresse. Wenn Sie eine Standby-Datenbank hinzufügen oder die Datenbank verschieben, ändern Sie nur einen Datensatz, anstatt alles neu bereitzustellen.
Wenn es Zeit zum Wachsen ist, befolgen Sie diese Reihenfolge:
- Fügen Sie zuerst eine Replik oder eine Reserve hinzu. Es schützt Ihre wertvollste Ebene, die Daten, und verändert Ihren Code kaum.
- Als nächstes sollte die App-Ebene horizontal skaliert werden. Stateless-Server hinter einem Load Balancer sind kostengünstig und risikoarm.
- Zersplittere nur, wenn es unbedingt nötig ist. Sharding verändert die Art und Weise, wie Ihre App Daten abfragt. Warten Sie daher, bis ein primärer Datenspeicher wirklich nicht mehr ausreicht.
Der Zeitpunkt ist genauso wichtig wie die Reihenfolge. Beginnen Sie, sobald Ihre Spitzenwerte die 70%-Marke erreichen, nicht erst, wenn ein Ausfall Sie dazu zwingt. Eine geplante Migration dauert Wochen. Eine erzwungene dauert meist nur ein Wochenende und kostet Sie Schlaf und das Vertrauen Ihrer Kunden.
Häufig gestellte Fragen
Diese Fragen tauchen in fast jeder Planungsbesprechung auf, an der ich teilnehme. Hier sind die kurzen, praktischen Antworten.
Reicht ein einzelner Knoten für die Produktion aus?
Ja, für viele Arbeitslasten. Wenn Ihre Benutzer kurze Ausfälle akzeptieren und die Spitzenlast deutlich unter den Leistungsgrenzen des Servers bleibt, reicht ein Server völlig aus. Sorgen Sie für Sicherheit mit getesteten Wiederherstellungsmethoden, Warnmeldungen zu Festplatten- und Backup-Problemen sowie einem schriftlichen Wiederherstellungsplan. Fügen Sie einen zweiten Server erst dann hinzu, wenn Ausfallzeiten tatsächlich Kosten verursachen.
Was bedeutet ein 3-Knoten-Cluster und warum drei?
Ein Cluster mit drei Knoten führt denselben Dienst auf drei Maschinen aus, die sich auf einen gemeinsamen Status einigen, beispielsweise darauf, welcher Knoten der Leader ist. Drei ist die kleinste Anzahl, die einen Ausfall sicher übersteht. Die beiden verbleibenden Knoten bilden weiterhin eine Mehrheit und arbeiten daher weiter. Bei nur zwei Knoten hat nach einer Aufteilung keine Seite mehr die Mehrheit.
Wie viele Knoten benötigt meine Anwendung?
Beginnen Sie mit der geringsten Anzahl an Knoten, die Ihr Verfügbarkeitsziel erfüllen. Für viele Anwendungen bedeutet das einen Server oder zwei Anwendungsserver plus eine primäre und eine Standby-Datenbank. Cluster, die auf Abstimmung basieren, benötigen eine ungerade Anzahl an Knoten, üblicherweise drei oder fünf. Wenn jeder Knoten in Spitzenzeiten eine Auslastung von etwa 70 % erreicht, planen Sie den nächsten Knoten ein.
Kann ich später von einem Einzelknoten auf mehrere Knoten migrieren?
Ja, und die meisten Teams machen das so. Der Umzug verläuft reibungslos, wenn man sich frühzeitig vorbereitet. Die Anwendung sollte zustandslos bleiben, Sitzungen außerhalb des Anwendungsservers gespeichert und ein DNS-Name anstelle einer fest codierten IP-Adresse verwendet werden. Zuerst sollte eine Standby-Datenbank eingerichtet und anschließend die Anwendungsebene skaliert werden. Beginnen Sie mit der Skalierung, wenn die Spitzenauslastung 70 % erreicht, nicht erst nach einem Ausfall.
Verbessert die Multi-Node-Konfiguration die Leistung für jede Arbeitslast?
Nein. Mehrere Knoten erhöhen zwar den Gesamtdurchsatz für gut aufteilbare Aufgaben wie Webanfragen oder Batch-Jobs, verlangsamen aber oft einzelne Anfragen, da die Daten das Netzwerk durchlaufen und synchrone Schreibvorgänge auf Replikate warten müssen. Eine schreibintensive Anwendung mit einer primären Datenbank profitiert kaum von zusätzlichen Knoten. Beheben Sie zuerst langsame Abfragen.
Ist eine Mehrknotenkonfiguration dasselbe wie ein verteiltes System?
Fast, aber nicht ganz. Jede Multi-Node-Konfiguration läuft auf mehreren Rechnern und erbt daher die typischen Probleme verteilter Systeme wie Netzwerkverzögerungen und Teilausfälle. „Verteiltes System“ bezeichnet jedoch üblicherweise Software, die entwickelt wurde, um Arbeit oder Daten auf mehrere Knoten zu verteilen, wie beispielsweise Cassandra oder Kafka. Zwei Webserver hinter einem Load Balancer gelten zwar als Multi-Node-System, fühlen sich aber kaum verteilt an.
Lass deine Zahlen das Setup bestimmen
Beginnen Sie mit einem einzelnen Knoten. Erweitern Sie Ihr System erst, wenn Ausfallzeiten, Datenwachstum oder bestimmte Verkehrsmuster dies ausschließen. Fügen Sie weitere Knoten hinzu, wenn Ihre Spitzenwerte und Verfügbarkeitsanforderungen die Kosten rechtfertigen.
Sie können diesen Anruf diese Woche tätigen:
- 30 Tage Spitzendaten abrufen für CPU, RAM und Festplatte.
- Notieren Sie Ihre akzeptable monatliche Ausfallzeit. in Minuten.
- Gehen Sie die fünf Fragen der Checkliste durch. mit diesen Zahlen in der Hand.
Wählen Sie dann die Architektur, die Ihre Arbeitslast erfordert, und nicht die, die beeindruckender klingt.
