


Das Wort „Knoten“ taucht überall auf, doch die Definitionen sind selten einheitlich. Sucht man nach der Bedeutung von „Multi-Node“, landet man innerhalb eines Nachmittags bei einer JavaScript-Laufzeitumgebung, einem Netzwerkdiagramm und einem Datenbankcluster. Kurz gesagt: Ein Serverknoten ist ein einzelner Rechner, der einen Teil eines größeren Systems ausführt. „Multi-Node“ bedeutet einfach, dass mehrere dieser Rechner zusammenarbeiten. Dieser Beitrag erklärt, was ein Serverknoten ist, was „Multi-Node“ in der Praxis bedeutet und wann Ihre Umgebung tatsächlich einen solchen Knoten benötigt.
Zunächst einmal: Schluss mit der Verwirrung: Node.js vs. Server-Node
Wenn Ingenieure fragen „Was ist ein Serverknoten?“, meinen sie meist etwas anderes, werden aber auf etwas anderes verwiesen. Das sollten wir zuerst ändern.
Ein Serverknoten ist ein einzelner Rechner – physisch, virtuell oder in einem Container –, der einen Teil eines größeren Systems ausführt und sich mit anderen Rechnern koordiniert, um die Arbeit zu verteilen. Diese Definition wird in diesem Artikel durchgehend verwendet.
Nun zur Klarstellung: Node.js ist eine JavaScript-Laufzeitumgebung zum Erstellen von Anwendungen. Das Wort ist dasselbe, hat aber nichts mit Serverknoten zu tun. Falls Sie über ein Backend-Tutorial hierher gelangt sind, meinen Sie wahrscheinlich genau das – und es hat nichts mit Clustern oder verteilten Servern zu tun.
Noch eine Falle. In Netzwerken bezeichnet ein „Knoten“ jedes Gerät, das Daten sendet oder empfängt – einen Router, einen Switch, einen Laptop. In verteilten Systemen ist ein „Knoten“ ein Mitglied eines Clusters, das koordinierte Aufgaben übernimmt. Dieser Beitrag meint die zweite Bedeutung: eine Maschine, die mit anderen zusammenarbeitet, um einen Dienst auszuführen.
Ein Serverknoten ist also ein funktionierendes Element eines größeren Systems. Alles Folgende baut darauf auf.
Was bedeutet „Multi-Node“ eigentlich?
Multi-Node bedeutet, dass zwei oder mehr Maschinen als ein logisches System zusammenarbeiten. Anstatt einen einzelnen, überdimensionierten Server mit allen Aufgaben zu belasten, wird die Arbeit auf mehrere Maschinen verteilt, die miteinander kommunizieren.
Stellen Sie sich den Unterschied vor. Eine Einzelknoten- (oder monolithische) Architektur führt Ihre Anwendung, Ihre Datenbank und Ihren Datenverkehr auf einem einzigen Rechner aus. Sie ist einfach zu implementieren und zu verstehen. Doch wenn dieser Rechner an seine Grenzen stößt oder ausfällt, steht alles still. Eine Mehrknoten- Architektur verteilt diese Aufgaben auf mehrere Rechner. Dadurch erhöht sich die Kapazität durch zusätzliche Hardware, und ein einzelner Ausfall führt nicht zum Ausfall des gesamten Systems.
Multi-Node ist kein Produkt, das man kauft. Es ist ein Muster, das sich durch den gesamten Stack zieht: Datenbankcluster, Webanwendungsschichten hinter einem Load Balancer, Message Queues und Container-Orchestrierungsplattformen wie Kubernetes. Jede dieser Architekturen setzt dasselbe Kernprinzip in unterschiedlicher Form um.
Für einen genaueren Einblick in die Hardware von Multi-Node-Servern und reale Einsatzszenarien, lesen Sie unseren Leitfaden „ Was ist ein Multi-Node-Server?“.
Serverknoten vs. Server: Was ist der Unterschied?
Diese beiden Begriffe werden oft synonym verwendet, was die weitere Kommunikation erschwert. Sie überschneiden sich zwar, sind aber keine Synonyme.
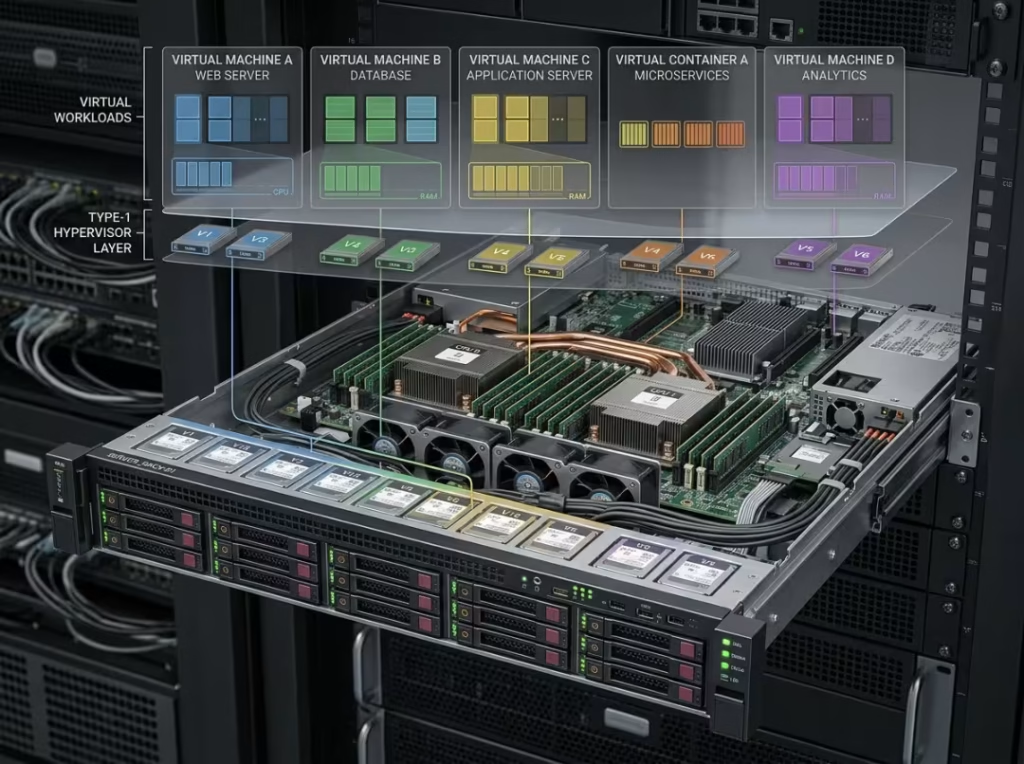
Ein Server ist eine physische oder virtuelle Maschine, die einen Dienst bereitstellt. Ein Knoten ist ein Mitglied eines größeren Clusters oder Netzwerks. Diese Unterscheidung ist wichtig, da ein einzelner physischer Server mehrere Knoten gleichzeitig – über virtuelle Maschinen oder Container – hosten kann, die jeweils als unabhängiges Mitglied eines Clusters fungieren.
|
Bedingungen |
What It Is |
Geltungsbereich |
|---|---|---|
|
Server |
Eine Maschine, die einen Dienst anbietet |
Eigenständig; kann eigenständig existieren |
|
Knoten |
Ein Mitglied eines Clusters oder Netzwerks |
Immer Teil einer größeren Gruppe |
|
Serverknoten |
Ein Server, der als ein Knoten in einem Cluster fungiert |
Der Schnittpunkt von beiden |
Die Begriffe werden oft verwechselt, weil in kleinen Umgebungen ein Server häufig einem einzelnen Knoten entspricht – beide Begriffe bezeichnen also dasselbe Gerät. Der Unterschied wird erst im größeren Maßstab deutlich, wenn ein Server mehrere Knoten hostet oder ein Cluster Dutzende von Maschinen umfasst.
Warum Teams Multi-Node-Setups nutzen
Bevor Sie sich mit den technischen Details befassen, sollten Sie verstehen, welches Problem dadurch gelöst wird. Teams wechseln aus fünf Gründen zu Multi-Node-Architekturen, und jeder dieser Gründe löst ein reales operatives Problem:
- Hohe Verfügbarkeit — Fällt ein Knoten aus, bedienen die anderen weiterhin den Datenverkehr. Es gibt keinen einzelnen Ausfallpunkt, der den Dienst lahmlegt.
- Horizontale Skalierung — Anstelle eines größeren, teureren Servers zusätzliche Maschinen zur Bewältigung der Last einzusetzen.
- Leistung unter Last — Die Anfragen werden auf mehrere CPUs, Speicherpools und Netzwerkschnittstellen verteilt, sodass keine einzelne Maschine zum Flaschenhals wird.
- Laufende Updates — Es wird jeweils ein Knoten neu gestartet und gepatcht, während die übrigen weiterlaufen. Für die Benutzer entstehen keine Ausfallzeiten.
- Geografische Reichweite — Knoten, die in verschiedenen Regionen platziert werden, reduzieren die Latenz für Benutzer, die weit von Ihrem primären Rechenzentrum entfernt sind.
Der rote Faden: Multi-Node-Architekturen tauschen Einfachheit gegen Ausfallsicherheit und Skalierbarkeit. Man nimmt höhere Komplexität in Kauf, erhält aber im Gegenzug ein System, das Ausfälle übersteht und ohne grundlegende Systemerweiterungen wachsen kann.
Wie Mehrknotensysteme funktionieren
Drei Dinge sind für das Funktionieren eines Clusters entscheidend: Koordination, Konsistenz und Wiederherstellung. Stimmen diese drei Aspekte, verhält sich eine Gruppe separater Maschinen wie ein einziges, zuverlässiges System. Stimmen sie nicht, entsteht etwas, das anfälliger ist als der einzelne Server, den man ersetzt hat. Genau hier liegt die wahre Ingenieurskunst.
Die Steuerungsebene und die Worker-Knoten
„Die Knoten kommunizieren miteinander“ ist zwar richtig, aber nutzlos. Was tatsächlich den Ablauf steuert, ist eine Befehlsstruktur.
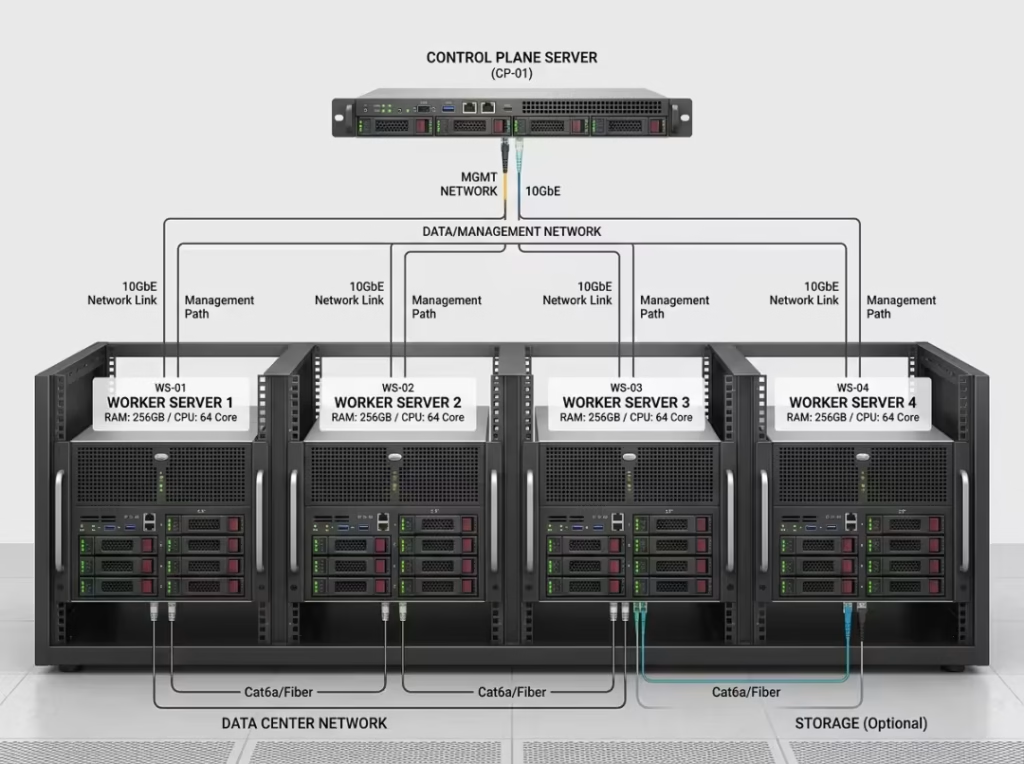
Die meisten Cluster teilen sich in zwei Rollen auf. Die Steuerungsebene trifft Entscheidungen – wo Arbeit eingeplant wird, welche Knoten fehlerfrei funktionieren und wie die Arbeitslasten verteilt werden. Die Worker-Knoten führen den eigentlichen Anwendungscode aus. Die Steuerungsebene ist das Gehirn, die Worker-Knoten sind die Hände.
Kubernetes ist das beste Beispiel. Seine Steuerungsebene plant Container und überwacht den Clusterstatus, während ein Pool von Worker-Knoten die containerisierten Workloads ausführt. Beim Deployment einer Anwendung wählen Sie keine Maschine aus – die Steuerungsebene entscheidet, wo sie eingesetzt wird. Das ist verteiltes Rechnen in der Praxis: Das System platziert und verschiebt Aufgaben, ohne dass Sie jede einzelne Maschine verwalten müssen.
Im Hintergrund verwalten Koordinationssysteme wie etcd oder ZooKeeper den gemeinsamen Zustand, auf den jeder Knoten angewiesen ist. Sie speichern die einzige verlässliche Quelle darüber, was wo ausgeführt wird, und ermöglichen es den Knoten, sich zu einigen, selbst wenn mehrere gleichzeitig Änderungen vornehmen.
Die Steuerungsebene überwacht den Status der Knoten anhand von Herzschlägen – kleinen, regelmäßigen Statussignalen von jedem Knoten. Bleiben einige Herzschläge aus, geht die Steuerungsebene davon aus, dass der betreffende Knoten ausgefallen ist, und reagiert entsprechend.
Datenkonsistenz und das CAP-Theorem, vereinfacht
Die Koordination regelt, wo die Arbeit ausgeführt wird. Die Konsistenz stellt sicher, dass alle Knotenpunkte die gleichen Daten verwenden . Diesen Punkt verstehen viele nur stillschweigend, daher wollen wir ihn konkretisieren.
Zwei Mechanismen erledigen den Großteil der Arbeit. Replikation speichert Kopien derselben Daten auf mehreren Knoten, sodass bei einem Ausfall keine Daten verloren gehen. Sharding teilt einen Datensatz in kleinere Teile auf und verteilt jeden Teil auf einen anderen Knoten, sodass keine einzelne Maschine alle Daten speichert. Kopien für Datensicherheit, Teile für Skalierbarkeit – viele Systeme nutzen beides gleichzeitig.
Die größte Herausforderung besteht darin, die Übereinstimmung der Replikate sicherzustellen. Hier kommt das Quorum ins Spiel: Eine Mehrheit der Knoten muss eine Änderung bestätigen, bevor der Cluster sie übernimmt. In einem Cluster mit drei Knoten müssen mindestens zwei Knoten zustimmen. Dadurch wird verhindert, dass die beiden Hälften eines geteilten Clusters widersprüchliche Schreibvorgänge akzeptieren.
Das CAP-Theorem klingt zwar akademisch, lässt sich aber auf einen Satz reduzieren: Wenn sich das Netzwerk aufteilt und Knoten einander nicht mehr erreichen können, muss man sich zwischen Konsistenz und Verfügbarkeit entscheiden – beides gleichzeitig ist nicht möglich. Entweder verweigert das System Schreibvorgänge, bis die Konsistenz sichergestellt ist, oder es akzeptiert sie und gleicht sie später ab.
Welche Lösung Sie wählen, hängt vom Arbeitsaufwand ab. In einem Bankbuch ist Konsistenz wichtig; Sie lehnen lieber eine Transaktion ab, als einen falschen Kontostand zu erfassen. In einem Social-Media-Feed hingegen ist Verfügbarkeit entscheidend; ein etwas älterer Beitrag ist besser als eine Fehlermeldung. Es gibt keine allgemeingültige Antwort, sondern nur die richtige für Ihr Projekt.
Wie ein Failover tatsächlich abläuft
„Es schaltet automatisch um“ – hier verbergen sich viele Produktionsprobleme. Der tatsächliche Ablauf ist komplexer und es gilt, ihn zu verstehen.
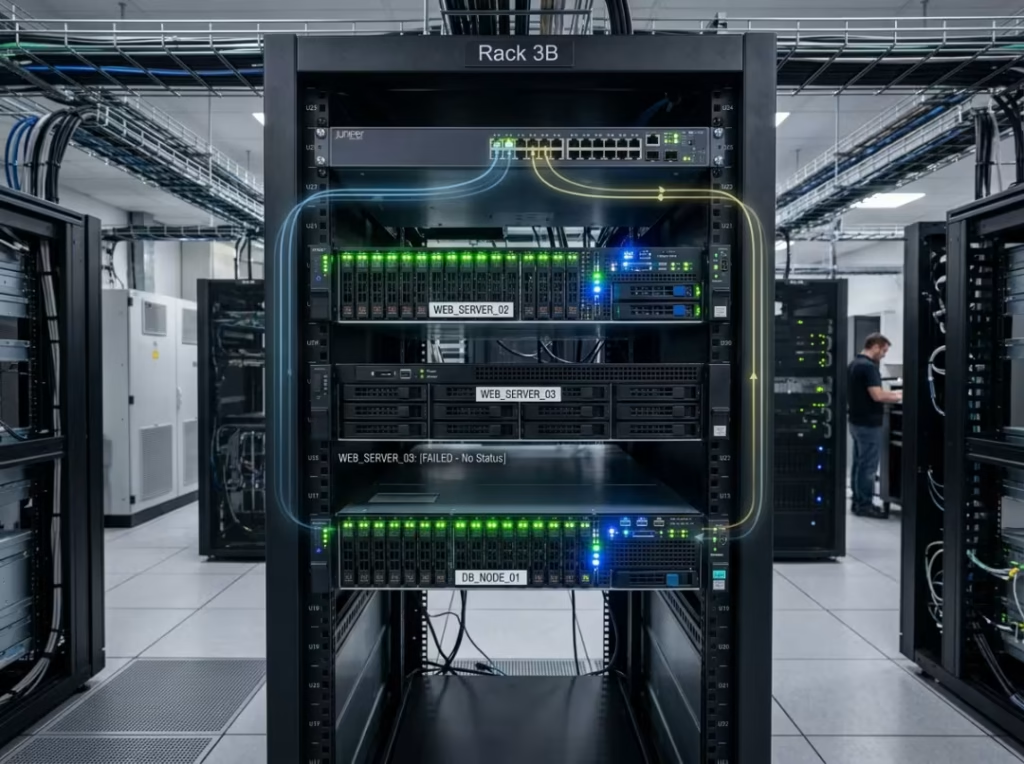
Wenn ein Knoten nicht mehr reagiert, erkennt der Orchestrator die fehlenden Heartbeats und markiert den Knoten als fehlerhaft. Der Datenverkehr wird auf die verbleibenden, funktionsfähigen Knoten umgeleitet, und alle Workloads, die auf dem ausgefallenen Knoten liefen, werden neu eingeplant. Für eine zustandslose Webschicht verläuft dieser Vorgang nahezu nahtlos.
Datenbanken sind komplexer, da die Daten einen festen Speicherort haben. Fällt ein primärer Datenbankknoten aus, wird eine Replik zum primären Knoten hochgestuft , damit Schreibvorgänge fortgesetzt werden können. Dieser Vorgang dauert einen Moment, und wie reibungslos er abläuft, hängt von der Clusterkonfiguration ab.
Dann folgt die Wahl des Leaders . Manche Cluster benötigen genau einen verantwortlichen Knoten – einen Koordinator, der die Entscheidungen trifft. Stirbt dieser Leader aus, wählen die verbleibenden Knoten einen neuen, üblicherweise nach demselben Quorumprinzip, das auch für Schreibvorgänge gilt. Bis zur endgültigen Entscheidung kann der Cluster bestimmte Operationen pausieren.
Ganz ehrlich: Je nach Design kann es beim Failover zu einer kurzen Unterbrechung kommen, manchmal aber auch zu gar keiner. Wer in jedem Fall unterbrechungsfreien Betrieb verspricht, will etwas verkaufen. Gutes Design verringert dieses Zeitfenster, beseitigt es aber selten vollständig.
Die zwei wichtigsten Multi-Node-Architekturen
Sobald das Konzept verstanden ist, stellt sich die Frage nach der passenden Form. Die meisten Mehrknotensysteme folgen einem von zwei Mustern.
Im Active-Active-Modus werden alle Knoten gleichzeitig genutzt, wobei ein Load Balancer den Datenverkehr gleichmäßig verteilt. Dadurch wird der Durchsatz maximiert und die Hardware optimal ausgenutzt. Im Active-Passive-Modus (auch Active-Standby genannt) läuft die Arbeitslast auf einem Knoten, während ein Standby-Knoten bereitsteht, um bei Ausfall des primären Knotens dessen Funktion zu übernehmen.
|
Architektur |
Funktionsweise |
Am besten geeignet für |
Achten Sie auf |
|---|---|---|---|
|
Aktiv-aktiv |
Alle Knoten verarbeiten den Datenverkehr gleichzeitig, Lastverteilung |
Leseintensive, skalierungsorientierte Workloads |
Es wird schwieriger, die Datenkonsistenz über alle Knoten hinweg zu gewährleisten. |
|
Aktiv-Passiv |
Ein Knoten ist in Betrieb, der Standby-Knoten wartet auf die Übernahme. |
Strikte Konsistenz; einfaches, vorhersehbares Failover |
Die Hardware im Standby-Modus bleibt ungenutzt, sodass Sie für Kapazität bezahlen, die Sie nicht verwenden. |
Managed Cloud Services verbergen einen Großteil dieser technischen Infrastruktur. Amazon RDS Multi-AZ, Google Kubernetes Engine und Azure SQL übernehmen Replikation, Failover und Koordination für Sie. Der Nachteil: Sie erhalten Ausfallsicherheit ohne operativen Aufwand, verzichten aber auf detaillierte Anpassungsmöglichkeiten und sind an die Vorgehensweise eines Anbieters gebunden.
Praxisbeispiele für Mehrknotensysteme
Das Muster greift, sobald man es mit bereits bekannten Systemen verknüpft:
- Webanwendungsebenen — mehrere Anwendungsserver hinter einem Load Balancer, von denen jeder einen Teil der Anfragen bearbeitet.
- Verteilte Datenbanken — Cassandra, Sharded MongoDB und CockroachDB verteilen Daten und Abfragen auf mehrere Knoten.
- Kubernetes-Worker-Knotenpools — Containerisierte Workloads, die auf einer Flotte von Maschinen eingeplant werden.
- CDNs — Inhalte werden auf Edge-Knoten in der Nähe der Nutzer zwischengespeichert, sodass Anfragen nie an einen einzigen Ursprungsserver gesendet werden.
- Kafkaeske Zustände — eine Message Queue, die Partitionen zur Erhöhung des Durchsatzes und der Datenbeständigkeit auf mehrere Broker verteilt.
Unterschiedliche Bereiche, gleiche Grundidee: die Arbeit verteilen, Misserfolge überstehen.
Wann Sie bei einem Einzelknoten bleiben sollten
Fast jeder Artikel geht davon aus, dass Multi-Node-Systeme das Ziel sind. Das stimmt nicht immer. Das Hinzufügen von Knoten zu einem System, das sie nicht benötigt, führt lediglich zu mehr Komplexität und höheren Kosten.
Arbeiten Sie dies durch, bevor Sie die Skalierung vornehmen:
- Beginnen wir mit der Anforderung. Benötigen Sie wirklich hohe Verfügbarkeit, mehr Skalierbarkeit oder beides? Falls keines von beidem zutrifft, können Sie hier aufhören.
- Ermitteln Sie die tatsächlichen Kosten. Mehr Knoten bedeuten mehr Angriffsfläche für Überwachung, Fehlerbehebung und Debugging. Verteilte Fehler sind schwieriger aufzuspüren als Fehler auf einem einzelnen Rechner.
- Berücksichtigen Sie die Netzwerkabhängigkeit. Sobald die Knoten miteinander kommunizieren müssen, hören Partitionen und Latenz auf, Leistungsprobleme zu sein, und werden zu Korrektheitsproblemen.
- Betrachten Sie einen einzelnen, ausreichend dimensionierten Knoten mit soliden Backups. Bei kleinen Anwendungen, Entwicklungsumgebungen und Diensten mit geringem Datenverkehr ist oft ein leistungsstarker Rechner mit einem erprobten Wiederherstellungsplan die beste Wahl.
Bleiben Sie bei einem Einzelknoten, wenn: Ihr Datenverkehr überschaubar ist, Ihre Daten problemlos auf einen Rechner passen, ein kurzer Ausfall tolerierbar ist und Sie in einer einzigen Region tätig sind.
Setzen Sie auf Multi-Node, wenn: Ausfallzeiten echtes Geld kosten, der Datenverkehr die Kapazität eines einzelnen Servers übersteigt oder Sie in mehreren Regionen präsent sein müssen.
Die Regel ist klar: Füge Knoten nur dann hinzu, wenn du Beweise dafür hast, dass du sie brauchst, nicht aus Prinzip.
Häufig gestellte Fragen
Worin besteht der Unterschied zwischen einem Knoten und einem Server?
Ein Server ist ein Rechner, der einen Dienst bereitstellt. Ein Knoten ist ein Mitglied eines größeren Clusters. Ein Server kann mehrere Knoten über virtuelle Maschinen oder Container hosten, daher überschneiden sich die Begriffe, sind aber nicht identisch.
Ist Multi-Node-Computing dasselbe wie verteiltes Rechnen?
Sie hängen eng zusammen. Verteiltes Rechnen ist das weite Feld der Koordination mehrerer Rechner; ein Multi-Node-Setup ist eine konkrete Methode, dies zu realisieren. Jedes Multi-Node-System ist verteilt, aber „verteiltes Rechnen“ umfasst auch Konzepte, die über einen einzelnen Cluster hinausgehen.
Wie viele Knoten benötigen Sie für Hochverfügbarkeit?
Drei ist die übliche Basis. Quorumbasierte Systeme benötigen eine Mehrheit zur Zustimmung, und drei Knoten tolerieren einen Ausfall und bilden dennoch eine Mehrheit. Zwei Knoten können bei Stimmengleichstand keine Entscheidung treffen, weshalb ungerade Zahlen gewinnen.
Worin besteht der Unterschied zwischen Multi-Node- und Multi-Tenant-Architekturen?
Multi-Node ist ungefähr wie viele Maschinen Ein System betreiben. Multi-Tenant-Systeme drehen sich um … wie viele Kunden Sie teilen sich ein System. Es handelt sich um unabhängige Achsen – man kann entweder die eine, beide oder keine haben.
Garantiert der Einsatz mehrerer Knoten eine Ausfallfreiheit?
Nein. Mehrere Knoten verringern zwar das Ausfallrisiko und verkürzen die Fehlerfenster, aber ein Failover benötigt dennoch Zeit, und Clients können kurzzeitig unterbrochen werden. Ein gutes Design minimiert dieses Risiko; vollständig lässt es sich jedoch nicht eliminieren.
Was ist eine Multi-Node-Datenbank?
Eine Datenbank, die über mehrere Server läuft und Replikation und Sharding nutzt, um Verfügbarkeit und Skalierbarkeit zu gewährleisten. Beispiele hierfür sind Cassandra und CockroachDB.
Kann ein Laptop einen Multi-Node-Cluster für Entwicklungszwecke betreiben?
Ja. Tools wie kind, k3d oder Docker ermöglichen es, mehrere Knoten als Container auf einem Rechner auszuführen. Das ist ideal zum Lernen und Testen, auch wenn es keine realen Netzwerkausfälle simuliert.
Fazit
Multi-Node-Systeme lösen drei konkrete Probleme: Verfügbarkeit, Skalierbarkeit und Geschwindigkeit. Sie erreichen dies, indem sie Einfachheit gegen Ausfallsicherheit eintauschen – man akzeptiert mehr bewegliche Teile im Austausch für ein System, das Ausfälle übersteht und ohne kompletten Austausch skalierbar ist. Dieser Tausch ist nicht kostenlos und lohnt sich nicht immer.
Die richtige Entscheidung hängt von Ihrem tatsächlichen Datenverkehr, der maximal tolerierbaren Ausfallzeit und der Fähigkeit Ihres Teams ab, ein verteiltes System sicher zu betreiben. Beginnen Sie nach Möglichkeit mit einem einzelnen, gut konfigurierten Knoten und wechseln Sie zu einem Multi-Node-System, sobald die Anforderungen dies wirklich erfordern. Managed Services erleichtern diesen Schritt, dennoch müssen Sie verstehen, wie die Knoten koordinieren, ausfallen und konsistent bleiben, bevor Sie einen Knoten produktiv einsetzen.
