


Es gibt keine allgemeingültige Antwort auf die Frage, wie viele Server ein Rechenzentrum beherbergen sollte. Die Anzahl hängt von der Größe des Rechenzentrums, der Rackdichte, der Stromkapazität, der Kühlinfrastruktur und dem Server-Formfaktor ab. Kleine Serverräume können nur 10 Server aufnehmen; Hyperscale-Rechenzentren hingegen über 200,000. Bei KI- und HPC-Anwendungen sind die Rackdichte und das Gehäusedesign oft wichtiger als die reine Serveranzahl.
Fragt man einen Rechenzentrumsbetreiber nach der Anzahl der Server in seinem Rechenzentrum, erhält man selten eine exakte Zahl. Das ist keine Ausrede, sondern schlichtweg korrekt. Die Serveranzahl ist ein abgeleiteter Wert, der von der Rack-Konfiguration, dem Energiebudget, der Kühlleistung und den physischen Abmessungen jedes installierten Gehäuses abhängt. Ein Rechenzentrum mit 1U-Servern und eines mit 4U-GPU-Knoten können die gleiche Stellfläche belegen, sich aber in der Gesamtzahl der Server um den Faktor vier unterscheiden.
Diese Unterscheidung ist für alle relevant, die Serverinfrastruktur planen, beschaffen oder aufbauen. Die Dimensionierung einer neuen Bereitstellung, der Vergleich von Einrichtungen oder die Auswahl von Gehäusen für einen hochdichten KI-Cluster erfordern ein klareres Verständnis der tatsächlichen Faktoren, die die Serveranzahl bestimmen – und nicht einen Faustregelwert.
Dieser Beitrag schlüsselt die Serveranzahl nach Anlagentyp auf, erläutert die Formeln, die Infrastrukturteams zur Kapazitätsschätzung verwenden, und untersucht, wie Entscheidungen bezüglich Gehäuseformfaktor und Rackdichte diese Zahlen beeinflussen, und zwar auf eine Weise, die durch reine Serveranzahlen niemals vollständig erfasst wird.
Typische Serveranzahl nach Rechenzentrumstyp
Die Anlagen variieren enorm in ihrer Größe, von einem einzelnen Serverraum bis hin zu einem Campus mit einer Leistung von mehreren hundert Megawatt. Die folgende Tabelle bietet praktische Referenzbereiche basierend auf der Anlagenklassifizierung.
|
Art der Anlage |
Typische Serveranzahl |
Häufiger Anwendungsfall |
|---|---|---|
|
Kleiner Serverraum |
10-200 |
KMUs, Filialen, Edge-Bereitstellungen |
|
Unternehmensrechenzentrum |
500-5,000 |
Unternehmens-IT, mittelgroße Cloud-Workloads |
|
Große Colocation-Einrichtung |
5,000–50,000 + |
Managed Hosting, Multi-Tenant-Cloud |
|
Hyperscale-Rechenzentrum |
50,000–200,000 + |
Hyperscaler (AWS, Google, Meta, Microsoft) |
Dies sind Richtwerte, keine festen Grenzwerte. Eine dichte Unternehmensimplementierung mit Blade-Servern kann auf relativ kleinem Raum über 5,000 Einheiten umfassen. Umgekehrt kann eine auf KI spezialisierte Einrichtung mit großen 4U-GPU-Gehäusen deutlich unter 5,000 Einheiten bleiben und gleichzeitig eine wesentlich höhere Rechenleistung pro Rack als eine herkömmliche Umgebung mit vielen 1U-Servern bieten.
Wie man die Serveranzahl in einem Rechenzentrum schätzt
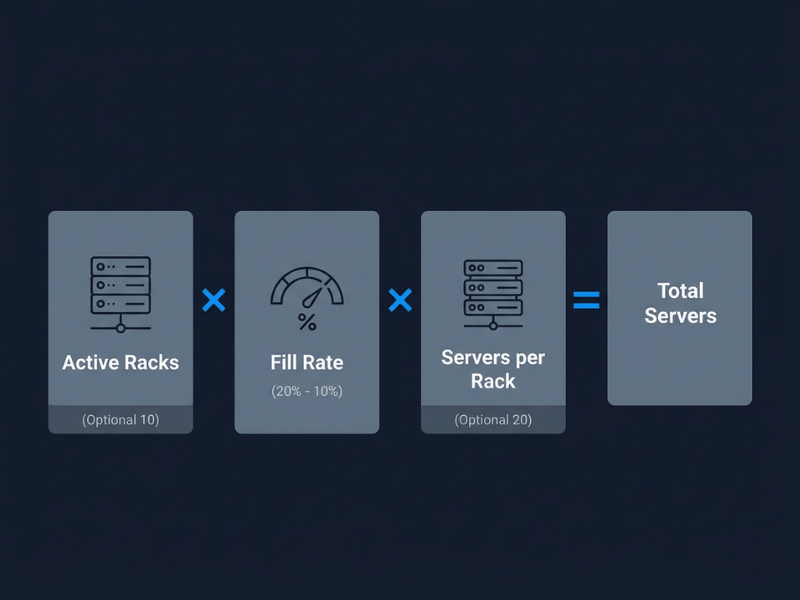
Infrastrukturplaner verwenden eine einfache Formel, um die gesamte Serverkapazität abzuschätzen:
Gesamtzahl der Server = Aktive Racks × Auslastungsgrad × Server pro Rack
Jede Variable birgt Nuancen der realen Welt.
- Aktive Racks Gemeint sind bestückte, mit Strom versorgte Racks – nicht die Gesamtkapazität der Racks im freien Raum.
- Füllrate Dies berücksichtigt die Tatsache, dass Racks selten zu 100 % belegt sind. Die typische Auslastung von Betriebseinrichtungen liegt zwischen 60 % und 80 %.
- Server pro Rack hängt vollständig vom Chassis-Formfaktor ab, der im nächsten Abschnitt ausführlich behandelt wird.
Beispiel 1: Standard-1U-Bereitstellung
Ein mittelgroßes Rechenzentrum für Unternehmen mit 100 aktiven Racks, einer Auslastung von 75 % und 1U-Servern (42 pro Rack bei voller Kapazität):
100 × 0.75 × 42 = 3,150 Server
Beispiel 2: Bereitstellung von 4U-GPUs mit hoher Dichte
Dieselbe Anlage, umkonfiguriert für KI-Inferenz-Workloads unter Verwendung von 4U-GPU-Gehäusen (10 Einheiten pro Rack bei voller Auslastung):
100 × 0.75 × 10 = 750 Server
Die Anzahl der Einheiten sinkt um 76 % – die Rechenleistung pro Rack steigt jedoch drastisch. Dieser Zielkonflikt ist der Hauptgrund, warum die Serveranzahl allein für die moderne Infrastrukturplanung kein vollständiges Kriterium darstellt.
Wie viele Server passen in ein Rack?
Ein Standard-Rack ist 42 HE hoch. Die Anzahl der darin aufzunehmenden Server hängt fast ausschließlich vom Gehäuseformfaktor ab.
|
Formfaktor |
Server pro 42U-Rack |
Typischer Anwendungsfall |
|---|---|---|
|
1U Rackmontage |
30-42 |
Allgemeine Rechenleistung, Webserver, Virtualisierung |
|
2U Rackmontage |
15-20 |
Speicherintensive Workloads, Rechenleistung im mittleren Bereich |
|
Blade (7U-Gehäuse) |
14–28 Klingen |
Hochleistungs-Unternehmensrechner |
|
4U-GPU-Gehäuse |
8-10 |
KI-Training und -Inferenz, HPC |
|
HCI (Hyperkonvergent) |
10–15 Knoten |
Konvergierte Rechen- und Speicherkapazität |
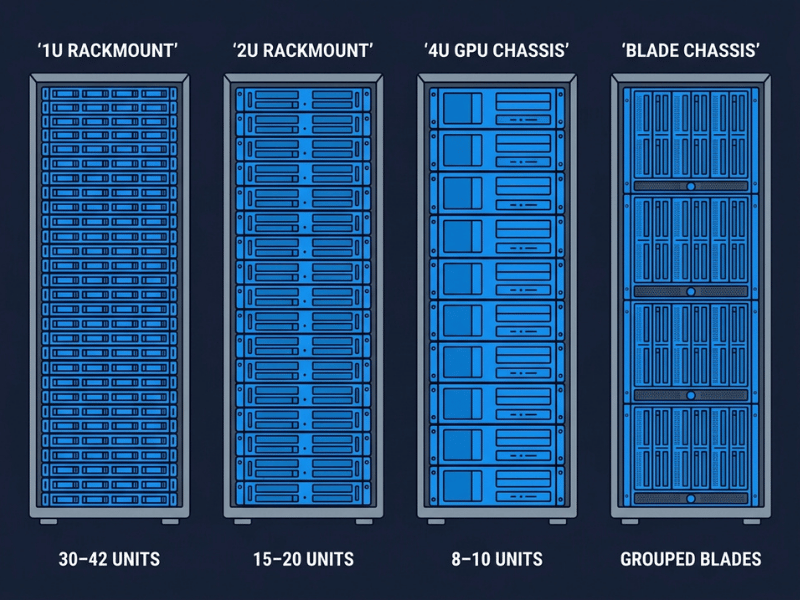
Der Wechsel von 1U-Allzweckservern zu 4U -GPU-Servergehäusen reduziert die Anzahl der Höheneinheiten pro Rack deutlich – jede Einheit bietet jedoch eine wesentlich höhere Rechenleistung. Ein einzelner 4U-GPU-Knoten mit acht High-End-GPUs kann einen höheren KI-Durchsatz erzielen als ein komplettes Rack mit 1U-Rechenknoten.
Was begrenzt tatsächlich die Anzahl der Server in einem Rechenzentrum?
Vier Faktoren begrenzen die Anzahl der Server, die eine Einrichtung physisch und betrieblich unterstützen kann. Das Verständnis jedes einzelnen Faktors hilft Planern, kostspielige Fehlkalkulationen zu vermeiden.
Verfügbare Rackanzahl und freie Fläche
Die gesamte nutzbare Bodenfläche – üblicherweise als freie Fläche bezeichnet – bestimmt die Anzahl der aufstellbaren Racks. Stromverteilung, Kühlinfrastruktur und Gangeinfassungssysteme beanspruchen neben den Racks selbst ebenfalls Bodenfläche. Dies ist die grundlegende Einschränkung, auf der alles Weitere aufbaut.
Leistungskapazität
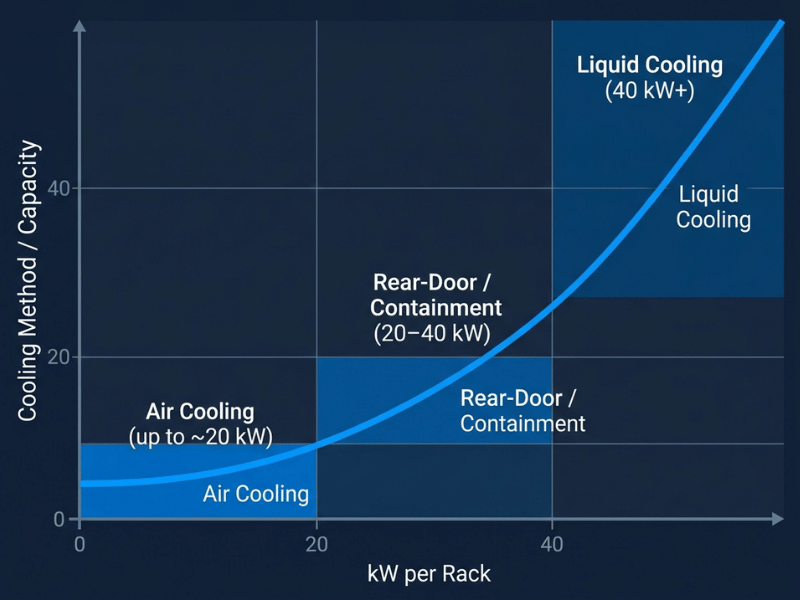
Die Leistungsaufnahme pro Rack ist oft der limitierende Faktor, insbesondere bei hoher Serverdichte. Traditionelle Rechenzentren benötigen im Durchschnitt etwa 8–12 kW pro Rack für allgemeine Rechenprozesse. Hochdichte GPU-Cluster benötigen üblicherweise 20–40 kW pro Rack , und einige flüssigkeitsgekühlte KI-Systeme überschreiten diesen Wert deutlich.
Wenn die Stromversorgungsinfrastruktur einer Einrichtung höhere Rackdichten nicht unterstützt, erfordert die Erweiterung der Serveranzahl entweder eine Reduzierung der Last pro Server oder umfangreiche elektrische Modernisierungsarbeiten – beides ist mit Kosten- und Zeitaufwand verbunden.
Kühlstrategie
Ab ca. 20 kW pro Rack stößt die Luftkühlung zunehmend an ihre Grenzen. In Einrichtungen mit herkömmlichen Klimaanlagen (CRAC/CRAH) erreichen die thermischen Grenzen eher die elektrischen als die thermischen. Flüssigkeitskühlung – ob Direktkühlung (DLC), Wärmetauscher an der Rückseite oder Vollkühlung – beseitigt diese Einschränkung, erfordert jedoch Kompatibilität mit dem Gehäuse. Da nicht jedes Rackmount-Gehäuse Flüssigkeitskühlungsverteiler unterstützt, ist die Kühlfähigkeit nicht nur ein Kriterium für die Einrichtung, sondern auch ein wichtiger Faktor bei der Gehäuseauswahl.
Server-Formfaktor
Wie die obige Tabelle zur Rackdichte zeigt, bestimmt die Gehäusehöhe direkt, wie viele Einheiten pro Rack Platz finden. Der Formfaktor beeinflusst aber auch den Luftstrom, die Netzteilkonfiguration und das Kabelmanagement – all dies wirkt sich auf die Zuverlässigkeit eines Racks bei hoher Dichte aus. Ein schlecht konstruiertes 4U-Gehäuse kann Hotspots erzeugen, die Betreiber zwingen, die Racks nicht voll auszulasten, wodurch die nutzbare Serveranzahl effektiv unter die rechnerisch mögliche Anzahl sinkt.
Warum die alleinige Serveranzahl in KI-Rechenzentren irreführend ist
Bei herkömmlichen IT-Workloads ist die Serveranzahl ein sinnvoller Indikator für die Kapazität. Für KI-Infrastrukturen ist sie ohne Kontext nahezu bedeutungslos.
Eine Anlage mit 10,000 1U-CPU-Servern und eine mit 1,000 4U-GPU-Knoten gehören trotz der zehnfach höheren Anzahl an Einheiten, die für die erstere spricht, völlig unterschiedlichen Leistungsklassen an. GPU-basierte Server für KI-Training und -Inferenz werden anhand folgender Kriterien evaluiert:
- Anzahl der GPUs pro Knoten (üblicherweise 4, 8 oder 16 GPUs pro Gehäuse)
- Leistungsaufnahme auf Rackebene (oft 20–40+ kW)
- Speicherbandbreite und Verbindungen (NVLink, InfiniBand)
- Kühlkonfiguration (Luft vs. Flüssigkeit vs. Hybrid)
Beim Vergleich von KI-Rechenzentren – oder bei der Planung einer KI-Implementierung – sind Rackdichte und Gehäusedesign wichtiger als die Gesamtzahl der Server. Ein Hyperscale-KI-Campus mit 50,000 GPU-Knoten bietet einen völlig anderen Durchsatz als 50,000 Allzweckserver, selbst wenn die Anzahl der Einheiten auf dem Papier identisch erscheint.
Wie beeinflusst das Gehäusedesign die Rackdichte in einem Rechenzentrum?
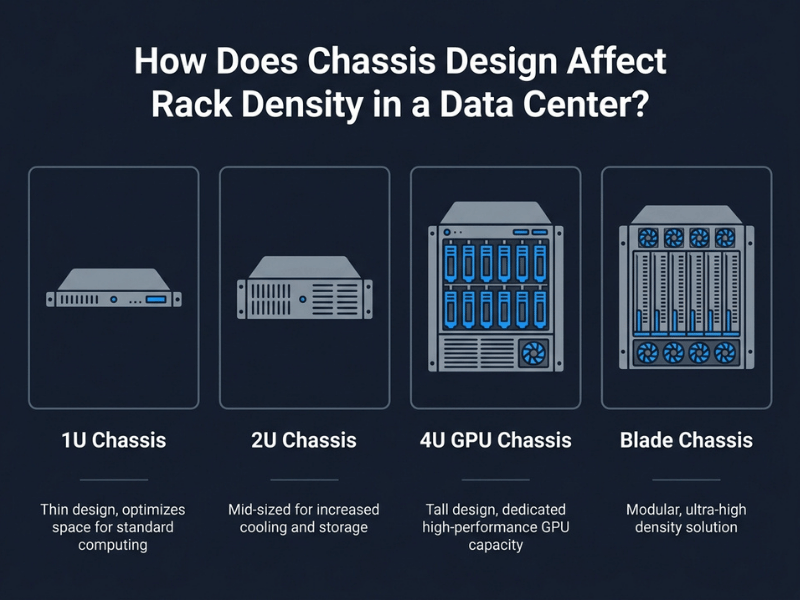
Beim Gehäusedesign trifft abstrakte Kapazitätsplanung auf die physische Realität. Die Entscheidungen auf Gehäuseebene – Höhe, Luftstromführung, Netzteilanordnung, Kabelmanagement und Kühlkompatibilität – beeinflussen direkt, wie dicht ein Rack bestückt werden kann und wie zuverlässig es unter Dauerlast arbeitet.
1U-Chassis
Optimal für hohe Geräteanzahlen pro Rack. Das Wärmemanagement ist durch das begrenzte interne Luftvolumen eingeschränkt, wodurch die Anzahl der GPUs pro Knoten in den meisten Designs auf 1–2 Karten begrenzt ist. Gut geeignet für rechenintensive, aber nicht GPU-intensive Workloads.
2U-Chassis
Bietet mehr Innenvolumen für Luftzirkulation und Komponentenanordnung. Unterstützt 2–4 GPUs pro Knoten in vielen Konfigurationen. Ein praktischer Kompromiss für gemischte Rechen- und Speicherlasten, bei denen eine moderate GPU-Dichte erforderlich ist.
4U-GPU-Gehäuse
Das dominierende Gehäuseformat für KI- und HPC-Anwendungen. Das interne Volumen bietet Platz für 8–16 GPU-Karten pro Node sowie für leistungsstarke Netzteile (2,000 W+), mehrere NVMe-Laufwerke und optimierte Luftzirkulation – oder Flüssigkeitskühlung in neueren Designs. Die OneChassis GPU-Servergehäuse sind speziell für dieses Anwendungsprofil entwickelt und bieten Konfigurationen, die eine vollständige GPU-Bestückung und für den dauerhaften Betrieb unter Volllast ausgelegte Wärmeleitpfade unterstützen.
Blade-Chassis
Mehrere Rechenknoten teilen sich ein gemeinsames Gehäuse, eine gemeinsame Backplane und oft auch eine gemeinsame Stromversorgung. Blade-Konfigurationen erreichen eine hohe Dichte pro Höheneinheit (HE), bieten aber aufgrund der begrenzten Steckplätze pro Blade weniger Flexibilität bei der GPU-Erweiterung – eine wesentliche Einschränkung für KI-Workloads, die eine hohe Anzahl von GPUs pro Knoten erfordern.
Der entscheidende Punkt: Zwei 4U-Gehäuse unterschiedlicher Hersteller, die im selben Rack installiert sind, können je nach Luftstromdesign, Netzteilposition und der Möglichkeit einer rückseitigen Abluftführung sehr unterschiedliche thermische Ergebnisse liefern. Die Rackdichte ist nicht nur eine Frage der Anzahl der Einheiten – sie ist ein konstruktionstechnisches Ergebnis, das auf Gehäuseebene festgelegt wird.
Wie man ein Gehäuse für den Einsatz von GPUs mit hoher Dichte auswählt
Die Auswahl eines Servergehäuses für eine Umgebung mit hoher Dichte erfordert die Abstimmung der Gehäusespezifikationen auf die Einsatzanforderungen in vier Dimensionen.
GPUs pro Knoten
Definieren Sie zunächst die für Ihre Arbeitslast benötigte GPU-Anzahl. Ein 8-GPU-Knoten für verteiltes Training benötigt ein 4U-Gehäuse mit großzügiger PCIe-Lane-Zuweisung und einer Backplane, die für die GPU-zu-GPU-Kommunikation mit voller Geschwindigkeit ausgelegt ist. Die Wahl eines Gehäuses, das die GPU-Anzahl begrenzt, erfordert entweder mehr Server (und damit mehr Rackplatz) oder eine geringere Leistung pro Knoten – beides ist in einer kostenoptimierten Implementierung nicht akzeptabel.
Rack-Leistungsdichte
Passen Sie die Netzteilkonfiguration des Gehäuses an die Stromzuweisung Ihres Racks an. Ein 4U-Gehäuse mit acht High-End-GPUs kann allein 6–8 kW verbrauchen. Bei 10 Einheiten pro Rack steigt der Stromverbrauch auf Rack-Ebene auf 60–80 kW – weit über dem üblichen Budget für Strom und Kühlung in Gebäuden. Gehäuse mit modularen, redundanten Netzteiloptionen bieten den Installationsteams die Flexibilität, die Stromversorgung pro Knoten innerhalb der vorgegebenen Rahmenbedingungen zu konfigurieren, ohne dabei auf Redundanz verzichten zu müssen.
Kühlstrategie
Prüfen Sie vor der Auswahl des Gehäuses, ob Ihre Einrichtung eine direkte Flüssigkeitskühlung unterstützt. Luftgekühlte 4U-Gehäuse mit optimierten Luftstrompfaden von vorne nach hinten eignen sich gut für eine Leistungsaufnahme von bis zu ca. 20–25 kW pro Rack. Darüber hinaus sind Gehäuse mit Vorbereitung für Flüssigkeitskühlung – mit Anschlusspunkten für Verteiler und geschlossenen CPU/GPU-Kühlkreisläufen – betrieblich erforderlich. OneChassis bietet OEM/ODM-Gehäusekonfigurationen mit Vorbereitung für Flüssigkeitskühlung für Einrichtungen mit höheren Leistungsdichten in den Racks.
OEM/ODM-Anpassung
Standardmäßige Gehäuse von der Stange erfüllen selten alle Anforderungen einer Installation exakt. OEM/ODM-Vereinbarungen ermöglichen es Betreibern und Systemintegratoren, individuelle I/O-Konfigurationen, Branding, Kabelführungen, Laufwerksschacht-Layouts und PCIe-Riser-Konfigurationen festzulegen. Bei großen Installationen reduzieren kundenspezifische Gehäuse den Integrationsaufwand und verbessern die Rack-Einheitlichkeit – beides senkt die Gesamtkosten über den gesamten Lebenszyklus der Anlage.
Rackdichte und Gehäusedesign sind die wahren Kennzahlen.
Die Anzahl der Server liefert einen Ausgangspunkt, aber selten das vollständige Bild. Die entscheidenden Fragen für Infrastrukturentscheidungen sind: Wie viele Racks haben Sie? Wie hoch ist Ihr Energiebudget pro Rack? Welche Workloads führen Sie aus? Und welches Gehäuseformat erfüllt diese Anforderungen?
Insbesondere bei KI- und HPC-Implementierungen vollzieht sich bereits der Wandel von der Serverzählung hin zur Optimierung der Rackdichte pro Watt. Einrichtungen werden heute primär nach Stromversorgung und Wärmemanagement geplant, wobei die Gehäuseauswahl und die Anzahl der Einheiten von diesen Anforderungen abgeleitet werden – und nicht umgekehrt.
Planen Sie eine Installation mit hoher Dichte oder evaluieren Sie Gehäuseoptionen für einen GPU-Cluster? OneChassis bietet Ihnen eine umfassende Auswahl an GPU-Servergehäusen und Rackmount-Gehäusen für anspruchsvolle Einsatzumgebungen. Für Unternehmen mit spezifischen Anforderungen an Formfaktor, Kühlung oder Branding sind OEM/ODM-Konfigurationen verfügbar. Kontaktieren Sie das OneChassis-Team, um die Gehäusespezifikationen für Ihre nächste Installation zu besprechen.
Häufig gestellte Fragen
Wie viele Server hat ein typisches Rechenzentrum eines Unternehmens?
Ein typisches Rechenzentrum eines Unternehmens beherbergt je nach Unternehmensgröße, Virtualisierungsgrad und Workload-Dichte zwischen 500 und 5,000 Server. Einrichtungen mit dichter Blade- oder 1U-Konfiguration weisen tendenziell höhere Serverdichten auf; solche mit größeren 2U- oder 4U-Servern tendieren zu niedrigeren.
Wie viele Server passen in ein Standard-42U-Rack?
Die Anzahl hängt vom Gehäuseformfaktor ab. Ein 42U-Rack bietet Platz für bis zu 42 1U-Server, 20 2U-Server oder 8–10 4U-GPU-Gehäuse. In der Praxis sind Auslastungsgrade von 60–80 % aufgrund von Einschränkungen bei Stromversorgung, Kühlung und Kabelmanagement üblich.
Reduzieren GPU-Server die Gesamtzahl der Server in einem Rechenzentrum?
Ja. GPU-Server nutzen größere 4U-Gehäuse, wodurch sich die Anzahl der Einheiten pro Rack im Vergleich zu herkömmlichen 1U-Servern reduziert. Ein Rack mit 42 1U-Servern bietet nur Platz für 8–10 4U-GPU-Gehäuse. Jeder GPU-Knoten liefert jedoch eine deutlich höhere Rechenleistung – eine geringere Anzahl an Einheiten bedeutet also nicht zwangsläufig eine geringere Kapazität für KI- oder HPC-Workloads.
Warum ist die Rackdichte in KI-Rechenzentren wichtiger als die Serveranzahl?
KI-Workloads sind GPU-limitiert, nicht CPU-limitiert. Die relevante Kennzahl ist die GPU-Rechenleistung pro Rack, gemessen am verfügbaren Leistungs- und Kühlbudget dieses Racks. Eine Einrichtung mit 1,000 Racks à 40 kW bietet einen deutlich höheren KI-Durchsatz als eine mit 2,000 Racks à 10 kW – selbst wenn letztere insgesamt mehr Server besitzt.
Welcher Gehäuseformfaktor eignet sich am besten für den Einsatz mit hoher GPU-Dichte?
4U-GPU-Gehäuse sind der Standard für KI- und HPC-Systeme mit hoher Dichte. Sie unterstützen 8–16 GPU-Karten pro Knoten, bieten Platz für redundante Netzteile mit hoher Kapazität und ausreichend Innenraum für ein effektives Wärmemanagement. Bei Systemen mit einer Leistungsaufnahme von über 20 kW pro Rack sind Gehäuse mit Vorbereitung für Flüssigkeitskühlung wichtig, um eine dauerhafte Leistung zu gewährleisten.
