


Standard-Servergehäuse wurden für CPUs, Festplatten und einen moderaten Stromverbrauch entwickelt. KI-Workloads haben das grundlegend verändert. Wenn Sie Modelle trainieren oder Inferenz in großem Umfang durchführen, entscheidet das gewählte Gehäuse darüber, ob Ihre GPUs ihre volle Leistung entfalten können oder ob sie stillschweigend ausgebremst werden. Hier sind fünf Gründe, warum ein speziell für GPUs entwickeltes Servergehäuse immer die beste Wahl ist.
Kühlere GPUs, kein Throttling. KI-Training beansprucht GPUs über Stunden oder Tage nahezu voll. Ein Standardgehäuse ist auf geringe CPU-Last ausgelegt und kann die benötigte Kühlleistung nicht erbringen. Die GPUs drosseln ihre Leistung, um eine Überhitzung zu vermeiden. Dieses Throttling verlängert die Trainingszeit und treibt die Rechenkosten in die Höhe. GPU-Servergehäuse lösen dieses Problem durch optimierte Belüftung oder, bei Dauerbetrieb, durch Flüssigkeitskühlung .
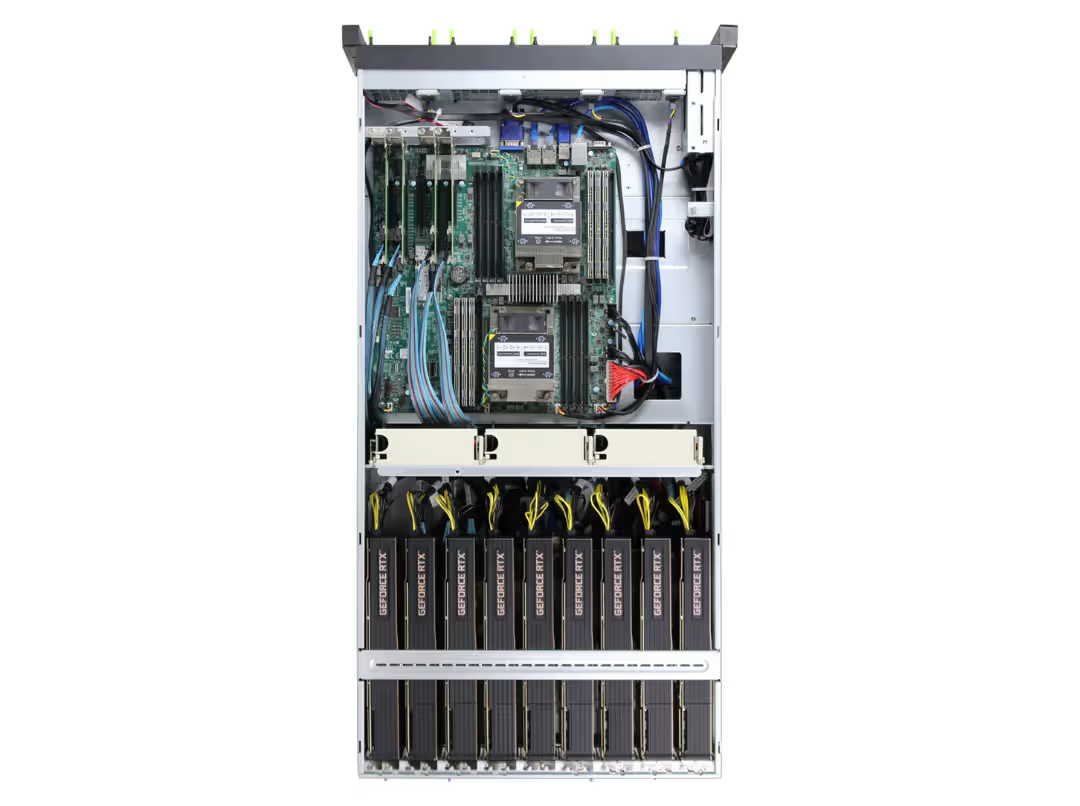
Mehr GPUs pro Gehäuse. Standardgehäuse bieten ein oder zwei Erweiterungssteckplätze. Das reicht für allgemeine Berechnungen, KI-Anwendungen benötigen jedoch parallele GPUs. GPU-Servergehäuse sind anders aufgebaut: Sie verfügen über verstärkte PCIe-Steckplätze und sind in Höhen von 4U bis 10U erhältlich. Ein 8U-GPU-Servergehäuse (OCG5800-8H4-L) integriert acht GPUs in ein einziges Gehäuse, sodass Ihre Infrastruktur kompakt bleibt und sich nicht über mehrere Racks erstreckt.
Leistung, die auch wirklich hält. KI-GPUs benötigen viel Strom, und dieser Bedarf steigt bei vier, acht oder mehr Karten rasant an. Standardgehäuse setzen auf ein oder zwei Netzteile, die für Speichersysteme ausgelegt sind. Werden die GPUs damit stark belastet, stößt man entweder an die Grenzen des sicheren Betriebs oder die Karten werden nicht ausreichend mit Strom versorgt. Servergehäuse für GPUs hingegen sind mit leistungsstarken Multi-Rail-Netzteilen ausgestattet, die genau für diese Belastung ausgelegt sind. Das ist der entscheidende Unterschied zwischen einem Gehäuse, das Spitzenlasten problemlos bewältigt, und einem, das daran scheitert.
Konstante Leistung auch bei langen Aufgaben. KI-Training läuft in langen, parallelen Zyklen, in denen alle GPUs gleichzeitig arbeiten, oft über die gesamte Dauer eines Auftrags. Das optimierte Wärmemanagement und die Stromversorgung sorgen gemeinsam für eine gleichbleibende Leistung von Anfang bis Ende, anstatt dass diese mit steigender Temperatur abfällt. Schnellere Auftragsabwicklung bedeutet geringere effektive Rechenkosten. Für Teams, bei denen die Fertigstellungszeit den Kostenfaktor bestimmt, amortisiert sich das Upgrade allein dadurch bereits.
Wachstumspotenzial. KI-Infrastrukturen entwickeln sich ständig weiter. Mit steigendem Bedarf werden GPUs hinzugefügt, Generationen aktualisiert und Cluster skaliert. Ein Standardgehäuse stößt schnell an seine Grenzen und muss komplett ausgetauscht werden. GPU-Servergehäuse bieten hingegen genügend Spielraum für dieses Wachstum, sodass Sie kostspielige Nachrüstungen mitten im Projekt vermeiden. Planen Sie einen größeren Cluster? Dann wählen Sie ein Gehäuse, das für Erweiterungen ausgelegt ist.
Der Unterschied liegt nicht in der persönlichen Vorliebe, sondern in der Technik. Ein Standardgehäuse, das bei Kühlung, Platzbedarf oder Stromversorgung unzureichend ist, kann Ihre gesamte KI-Implementierung ausbremsen. Entdecken Sie unser komplettes Sortiment an GPU-Servergehäusen , um das passende Gehäuse für Ihre GPU-Anzahl und Kühlanforderungen zu finden, oder kontaktieren Sie unser Team für OEM/ODM-Anpassungen. Lassen Sie das Standardgehäuse im Schrank.
